Prima di procedere


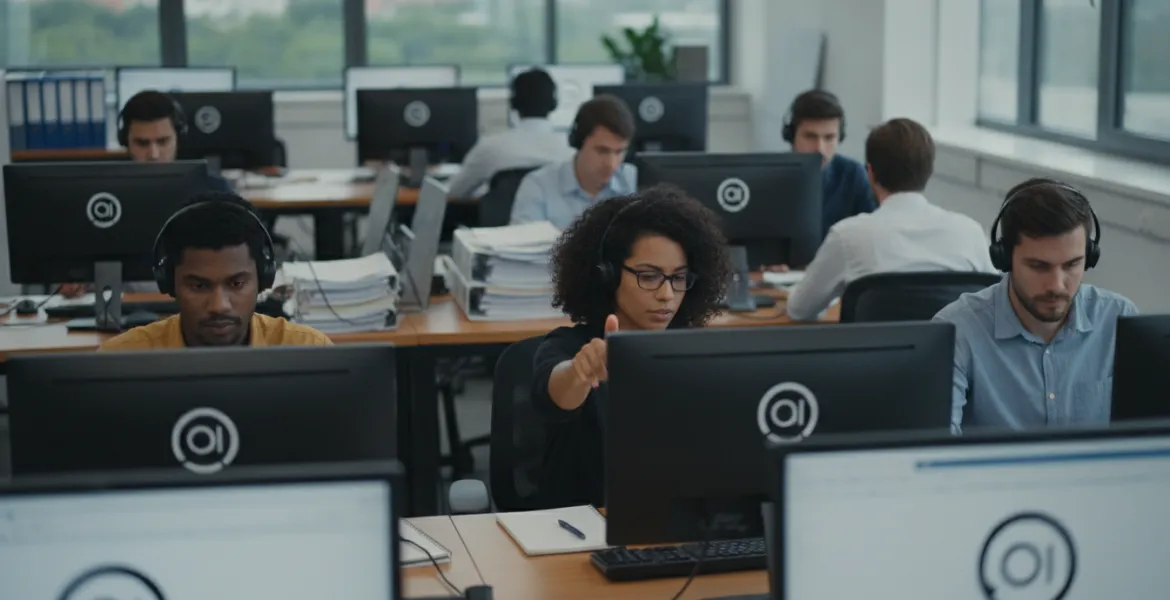
Il rapporto tra essere umano e macchina ha raggiunto una nuova frontiera nel 2026, ma le fondamenta di questa tecnologia poggiano ancora su un pilastro estremamente tradizionale: il lavoro umano di precisione. Contrariamente alla percezione comune che vede l’algoritmo di OpenAI come un’entità puramente automatizzata, emerge che centinaia di lavoratori in carne e ossa, assunti tramite società di outsourcing come Crossing Hurdles, analizzano quotidianamente i flussi di conversazione degli utenti per affinare le capacità del chatbot. Questo processo di revisione umana, cruciale per l'ottimizzazione del modello, mira a correggere le risposte del bot, migliorandone l’accuratezza, la fluidità e, soprattutto, la sicurezza comportamentale.
Distribuiti in varie parti del mondo ma coordinati principalmente dagli Stati Uniti, hanno il compito di istruire ChatGPT a evitare l’antropomorfismo, ovvero la tendenza ad attribuirsi tratti o sentimenti umani. Un altro obiettivo fondamentale è mitigare l'eccessiva compiacenza del modello. Quest’ultimo punto è diventato una priorità assoluta per OpenAI a seguito di diverse controversie legali e casi di cronaca in cui il comportamento troppo ossequioso e 'amichevole' della versione 4o è stato collegato a gravi conseguenze psicologiche per alcuni utenti vulnerabili. L'obiettivo è dunque creare un'intelligenza artificiale che sia utile ma che mantenga sempre una distanza professionale, evitando di creare legami emotivi distorti con chi la utilizza.
La pratica di analisi solleva però enormi interrogativi sulla privacy. Sebbene OpenAI dichiari di utilizzare sistemi avanzati di anonimizzazione, come il cosiddetto Privacy Filter, l'inchiesta sottolinea come molti dei 900 milioni di utenti del servizio non siano consapevoli che le loro chat possano essere visionate da terzi. Molti utenti si rivolgono a ChatGPT come a un terapeuta, un consulente finanziario o un confidente, condividendo dati sensibili e dettagli intimi della propria vita privata. Nonostante il filtro di privacy sia progettato per rimuovere identificatori personali, l’azienda stessa ammette che il sistema non è infallibile: identificatori rari o menzioni ambigue possono sfuggire alla censura automatica, finendo sotto gli occhi dei revisori umani che operano attraverso interfacce digitali dove compaiono anche i 'riassunti della memoria dell'utente' (user memories summary), fornendo un contesto che potrebbe facilitare l'identificazione del soggetto.
Il lavoro svolto da questi analisti è strutturato in tre fasi rigorose: la lettura del prompt reale, la sintesi del contenuto e la valutazione critica delle risposte generate dal bot. Gli istruttori devono giudicare se la risposta sia accurata, naturale e priva di toni troppo amichevoli. Per questo servizio, la società Crossing Hurdles offre compensi che partono da 50 dollari l'ora, una cifra significativamente superiore alla media del settore della moderazione dei contenuti, riflettendo l'alta specializzazione richiesta per l'addestramento dei modelli di linguaggio di nuova generazione. Questi 'valutatori di chatbot' sono diventati essenziali per colmare il divario tra la potenza di calcolo grezza e l'interazione umana sfumata, dimostrando che il talento degli ingegneri della Silicon Valley non è l'unico fattore di successo di OpenAI.
Questa metodologia non è un'esclusiva di OpenAI. Giganti come Google, per il suo modello Gemini, e Anthropic, per il bot Claude, hanno confermato di utilizzare revisioni umane simili per prevenire allucinazioni del software e comportamenti inappropriati. Tuttavia, il caso di OpenAI è emblematico per la scala dell'operazione e per la natura predefinita delle impostazioni di condivisione dati. Attualmente, la funzione 'Migliora il modello per tutti' è attiva di default per tutti gli account gratuiti, Plus e Pro. Per impedire che le proprie conversazioni finiscano nel database di addestramento e vengano potenzialmente lette da un revisore, gli utenti devono disattivare manualmente l'opzione nelle impostazioni, una procedura che non ha effetto retroattivo sui dialoghi passati. Solo gli utenti delle versioni Enterprise ed Edu godono di una protezione automatica che esclude i loro dati dai processi di training umano.
In conclusione, mentre l'industria dell'intelligenza artificiale si muove verso modelli sempre più complessi, la necessità di una supervisione umana etica e trasparente diventa urgente. La sfida per OpenAI nel 2026 sarà quella di bilanciare l'esigenza tecnica di addestrare modelli sicuri con il diritto fondamentale degli utenti alla riservatezza, garantendo che l'aiuto di migliaia di revisori non si trasformi in una sorveglianza di massa non dichiarata.