Google amplia la gamma di processori TPU di ottava generazione per l'intelligenza artificiale
I nuovi modelli TPU 8tx e TPU 8i Max migliorano la sicurezza dei dati sensibili e raddoppiano la capacità di memoria per la gestione di agenti autonomi complessi.
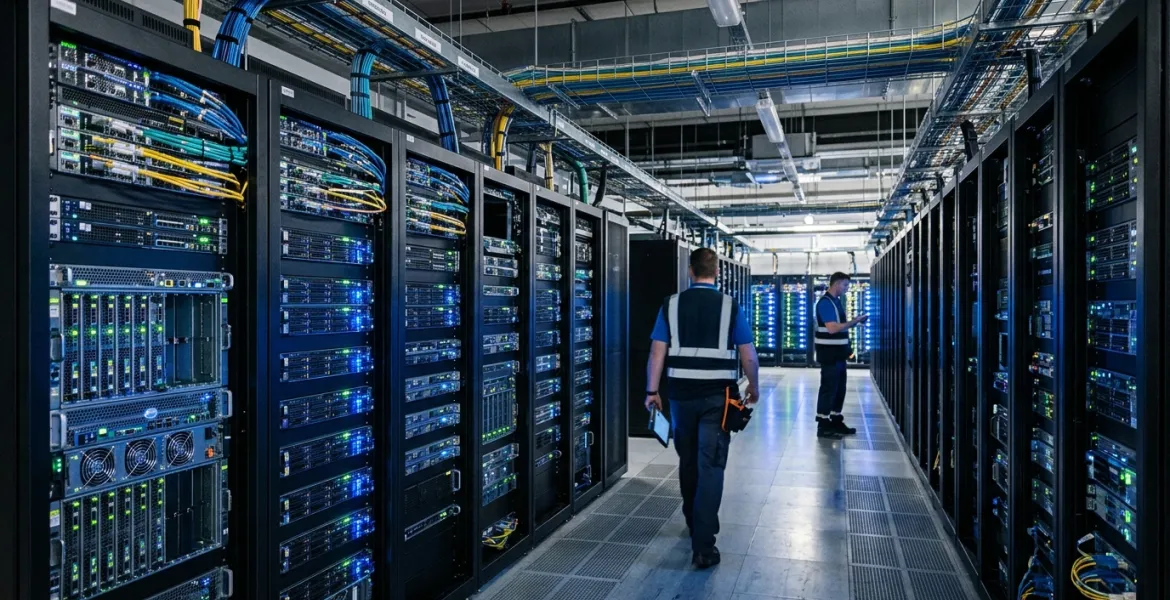
Google ha annunciato l'ampliamento della propria famiglia di processori di ottava generazione con il lancio dei nuovi modelli TPU 8tx e TPU 8i Max. Queste unità di elaborazione tensoriale sono state progettate per ottimizzare l'esecuzione delle operazioni di inferenza e la gestione di ampie finestre di contesto, con un'attenzione particolare alla sicurezza e alla densità di calcolo necessaria per il funzionamento degli agenti di intelligenza artificiale.
Il nuovo TPU 8tx si concentra sulla riservatezza dei dati, offrendo una soluzione per l'inferenza protetta a livello hardware. Questa architettura è destinata principalmente alle organizzazioni governative e alle imprese che operano in settori soggetti a rigide normative, dove è essenziale mantenere isolati i dati sensibili e i pesi dei modelli durante l'elaborazione. Grazie all'implementazione della rete Boardfly, caratterizzata da una bassa latenza, il sistema dimezza i tempi di risposta rispetto al modello TPU 8t senza compromettere le prestazioni complessive. Questa tecnologia permette ai team di effettuare il fine-tuning dei modelli su dataset privati e di addestrare agenti autonomi tramite apprendimento per rinforzo, evitando il trasferimento di informazioni riservate tra cluster differenti.
Parallelamente, Google ha presentato il TPU 8i Max, progettato per superare i limiti strutturali legati alla velocità della memoria. Il modulo integra due chip TPU 8i in un'unica unità, raddoppiando le risorse di calcolo, la memoria SRAM e la larghezza di banda della memoria HBM rispetto alla versione standard. Tale configurazione assicura che il processore disponga costantemente dei dati necessari per gestire carichi di lavoro su larga scala, permettendo ai data center di aumentare sensibilmente la potenza di calcolo disponibile per ogni unità di superficie e per watt consumato. Il modello TPU 8i standard continua invece a essere impiegato per compiti di ragionamento logico, con una riduzione della latenza nello scambio di dati tra i chip fino al 50%.
L'offerta si completa con il TPU 8t, uno strumento focalizzato sull'addestramento di modelli di base ad alte prestazioni, con l'obiettivo di massimizzare il volume di intelligenza prodotto per ogni unità di energia impiegata. L'integrazione di queste quattro varianti consente una gestione flessibile di ogni fase del ciclo di vita degli agenti intelligenti, spaziando dall'addestramento alla gestione di finestre di contesto massicce.
Sul fronte dello sviluppo software, l'azienda ha reso disponibile TorchTPU come progetto open source, permettendo ai modelli scritti in PyTorch e a quelli presenti nella libreria Hugging Face di essere eseguiti in modo nativo sulle TPU senza modifiche al codice. È stata inoltre garantita la compatibilità con motori di inferenza come vLLM e SGLang. Per facilitare l'ottimizzazione dei flussi di lavoro, è stato introdotto il kit TPU Agent, che si integra in ambienti di sviluppo quali Claude Code, Cursor e Google Antigravity. Infine, il nuovo XLA Serving Engine permette di tradurre i modelli addestrati in Python in un ambiente C++ ad alte prestazioni per l'esecuzione su TPU, GPU o CPU.
Articolo realizzato con il supporto di strumenti di intelligenza artificiale e verificato dalla redazione. Come lavoriamo
Responsabile editoriale di Infogioco, cura le sezioni Tecnologia, Videogiochi, Mondo e Attualità. Anna è una redattrice dinamica e carismatica, con una passione travolgente per il mondo dell'informatica e le innovazioni tecnologiche. Fin da giovane, ha sempre nutrito una curiosità insaziabile per come la tecnologia possa trasformare le vite delle persone. La sua carriera è caratterizzata da un costante impegno nell'esplorare le ultime novità in campo tecnologico e nel raccontare storie che ispirano e informano il pubblico.
Tutti gli articoli di Anna SulacPubblicato il 10 novembre 2026, 16:43 a cura di Anna Sulac per Infogioco.it.
Newsletter gratuita
Ogni venerdì le notizie della settimana nella tua casella
Le principali, le più lette e il punto sul gioco pubblico. Ti disiscrivi quando vuoi.